
万博manbext体育官网app娱乐E系列将矩阵乘法径直镶嵌GPU中枢-万博manbext体育官网(中国)官方网站登录入口
新闻资讯
你的位置:万博manbext体育官网(中国)官方网站登录入口 > 新闻资讯 > 万博manbext体育官网app娱乐E系列将矩阵乘法径直镶嵌GPU中枢-万博manbext体育官网(中国)官方网站登录入口
万博manbext体育官网app娱乐E系列将矩阵乘法径直镶嵌GPU中枢-万博manbext体育官网(中国)官方网站登录入口
发布日期:2026-09-23 12:28 点击次数:125
 万博manbext体育官网app娱乐
芯东西(公众号:aichip001)
作家 | ZeR0
剪辑 | 漠影
芯东西9月21日报谈,当天,Imagination Technologies公布了其E系列GPU IP的首批性能数据和演示收尾,并推出全新的Neural Super Resolution(NSR,神经超辞别率)AI加快超辞别率处理决策。首批基于E系列的芯片,展望将于本年晚些时候完成流片。
E系列具备通用诡计智商,接收熟悉的GPU编程模子并支柱行业表率API,使蛊惑者能在建立全生命周期内已毕新算子,并通过GPU内高度集成的Matrix Accelerator(矩阵加快器)加快,同期支柱BF16、FP4和MX等高精度与低精度数据技艺。
(1)AI:与上一代D系列比较,E系列在典型边际言语模子上的预填充性能晋升了4.7倍。以Qwen 3.5 4B为例,在典型责任负载下,一款1.5GHz的四核E系列GPU可已毕0.2秒的初度Token生成时候,以及每秒150个Token的解码吞吐量。
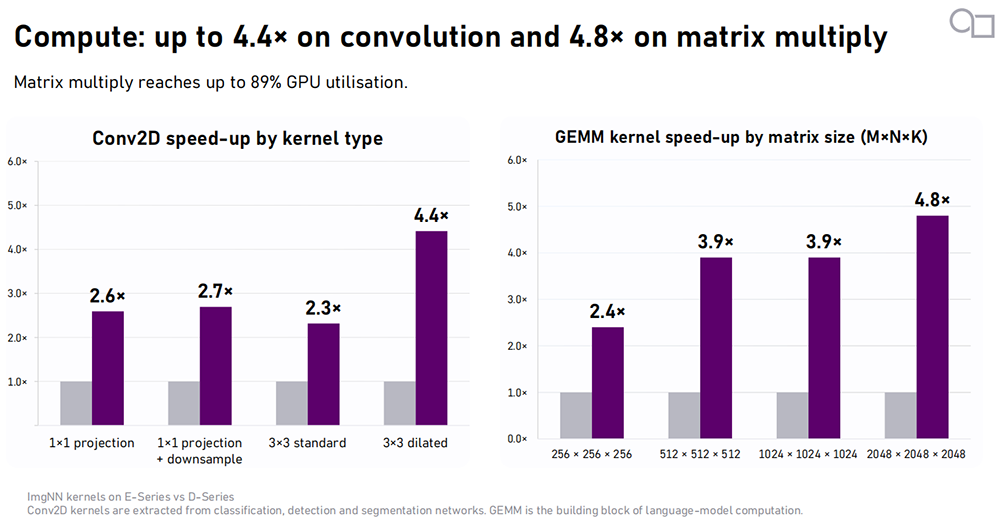
(2)基础诡计:E系列在AI、诡计机视觉、信号处理和通用诡计中平日使用的基础诡计操作方面晋升了性能。举例,与D系列同类居品比较,E系列入手Conv2D内核的速率快4.4倍,入手GEMM内核的速率快4.8倍。在矩阵乘法责任负载下,GPU欺诈率可达89%。
(3)神经渲染:在1GHz单核E系列GPU上,典型的540p到1080p超辞别率操作蔓延低至2.3毫秒。
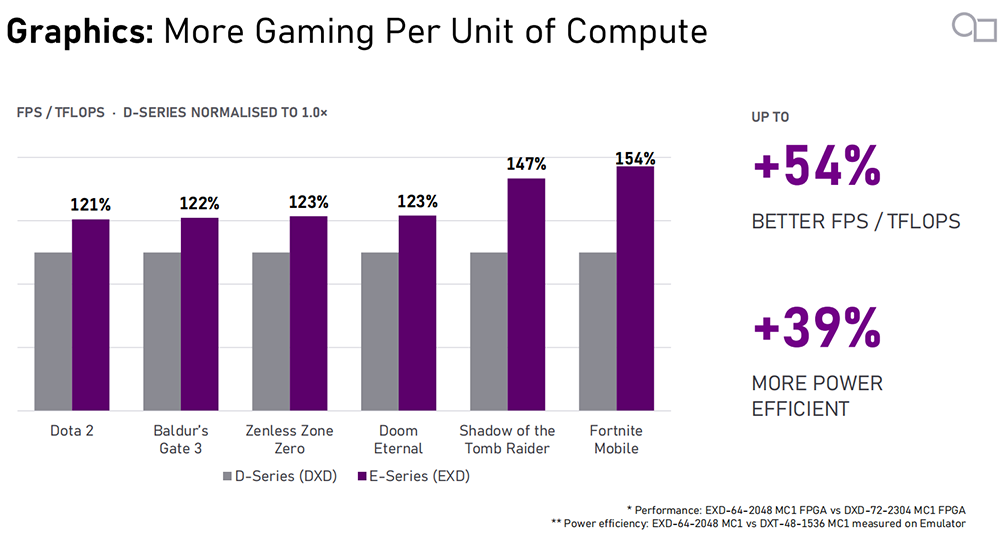
(4)游戏:与上一代同类居品比较,E系列性能晋升高达54%,其四核成就在部分AAA级桌面游戏中可已毕越过60fps的帧率,每瓦性能晋升最高达39%;新增支柱DirectX 12 FL11_0。
这些最新进展进一步体现了Imagination的GPU-first(GPU优先)计策:通过一套架构和一套软件栈,让芯片设想厂商概况入手图形、诡计和AI等不同类型的责任负载。
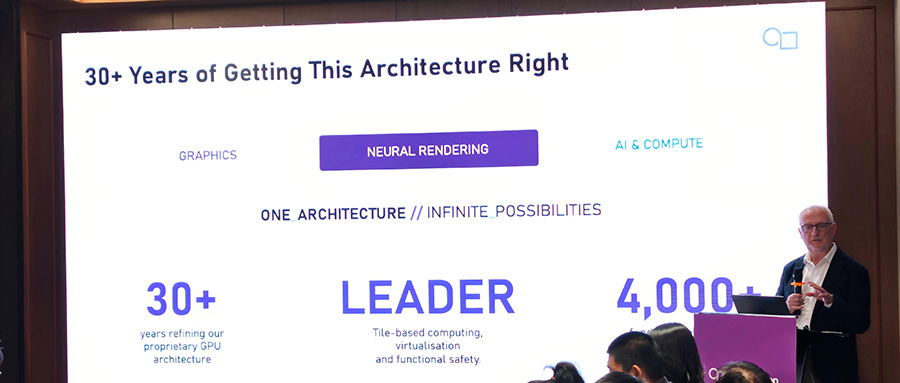
Imagination从事GPU架构研发越过30年,在图形处理除外,也合手续扩张神经渲染及AI和通用诡计智商。该公司已累积约4000项专利,各人授权客户越过50家,其中约18家来自中国。
Imagination Technologies的CEO Markus Mosen、首席营收官Jake Kochnowicz、实施副总裁兼中国区总司理William Xie近日与芯东西等媒体进行深切交流,分享E系列的架构改换及在中国市集的最新落地进展。据披露,Imagination已拿下一家新的贫困计策客户。
此前D系列提供通用GPU诡计库和SDK,并进入自动驾驶和机器东谈主等客户名堂。E系列进一步把更强的AI智商带进GPU中枢,提高矩阵、卷积和低精度诡计性能,是Imagination交融图形与AI道路的第一步。往日F系列及后续居品将连续已毕更大的GPU成就、更低精度的数据技艺,更高的效能。
一、诡计架构走向交融,GPU将是分享“诡计中心”
当今的SoC不时由CPU、GPU、DSP、NPU等多个诡计模块组成。不同单位之间通过外部内存交换数据,会产生三类本钱:
数据在外部内存往返搬运形成能耗。
数据通讯带来时延。
蛊惑过问的年工程和东谈主力本钱。
在Imagination看来,新增针对不同责任负载的专用加快模块、软件栈与数据通路,这种碎屑化不仅加剧系统集成职守,还可能使部分固定功能硬件在需求变化后闲置。
同期,在AI快速发展的驱动下,多样诡计模块之间的界限正在安闲糊涂,CPU加多向量和矩阵扩张,NPU支柱更大齐据技艺,GPU也在继承AI诡计和神经渲染。
Imagination合计,往日SoC需要一个分享、可编程的“诡计中心”,而GPU最有可能承担这一变装。
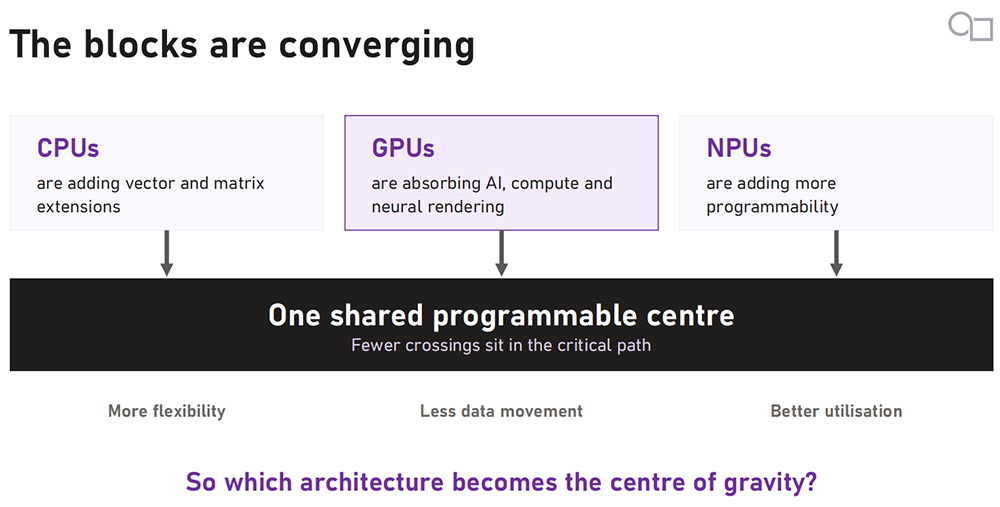
“诡计的重点正在往GPU弯曲,图形和AI靠得更近,需要调理内存、调理转变、调理软件栈。这一切九九归一即是两个字——效能。”Imagination Technologies CEO Markus Mosen说,“要最佳地处理效能,场地即是GPU。”
GPU具备几个基础要求。它兼具并行诡计智商、老到软件生态、通用纯真性与图形处明智商,既能作念图形处理,又能作念AI诡计和通用诡计。
由于AI模子和软件的变化速率不时快于硬件换代速率,可编程GPU也能为尚未出现的新负载保留适合空间。
跟着超辞别率、帧生成、智能助手和出产力用具进入末端建立,把更多AI智商放进GPU,不错复用已有硬件和软件资源。
E系列恰是为此而生。
二、让AI和图形处理分享GPU资源,减少数据搬运,提高GPU欺诈率
E系列GPU IP于旧年发布,提供多种成就,可袒护从智高手机到高性能系统的不同应用。
咫尺已有多家率先配结伙伴获取该本事授权。
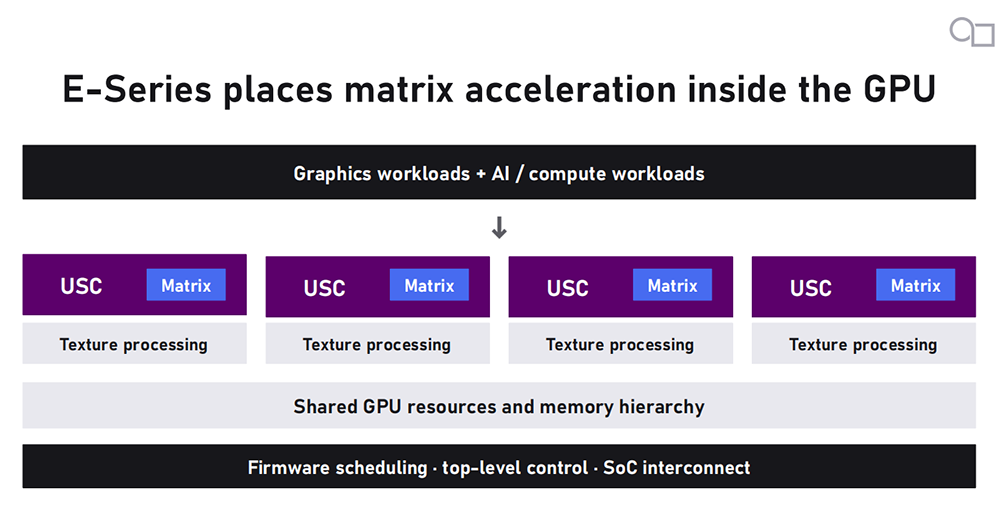
从架构来看,E系列将矩阵乘法径直镶嵌GPU中枢,放在图形单位傍边。这意味着AI诡计能复用GPU已有资源,分享寄存器、隔断、缓存、固件、驱动、蛊惑用具及生态。
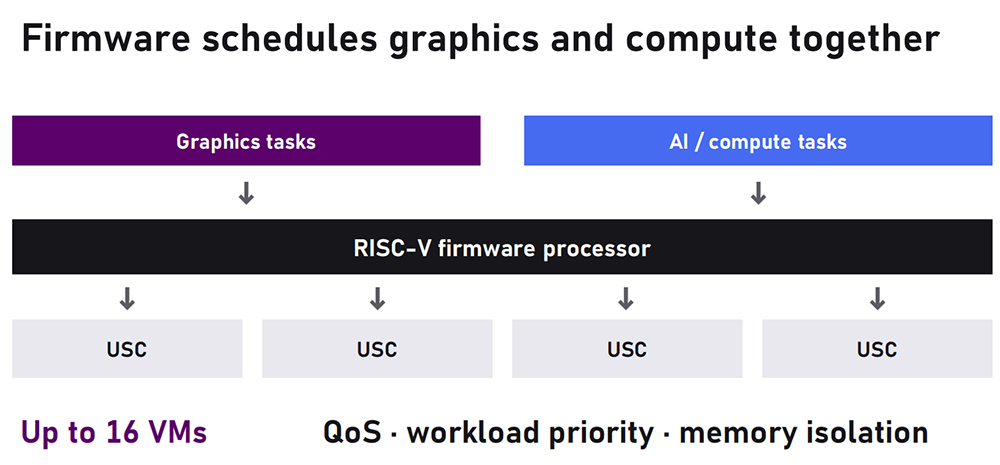
该GPU集成了Imagination自研的高性能RISC-V固件处理器,在GPU架构上将图形和诡计责任并行转变,底层最多支柱4核、16台凭空机,提供高质地作事、责任负载优先级和内存窒碍,这些智商不错用于云游戏、云桌面、汽车多域系统以及需要多个安全窒碍环境的边际平台。
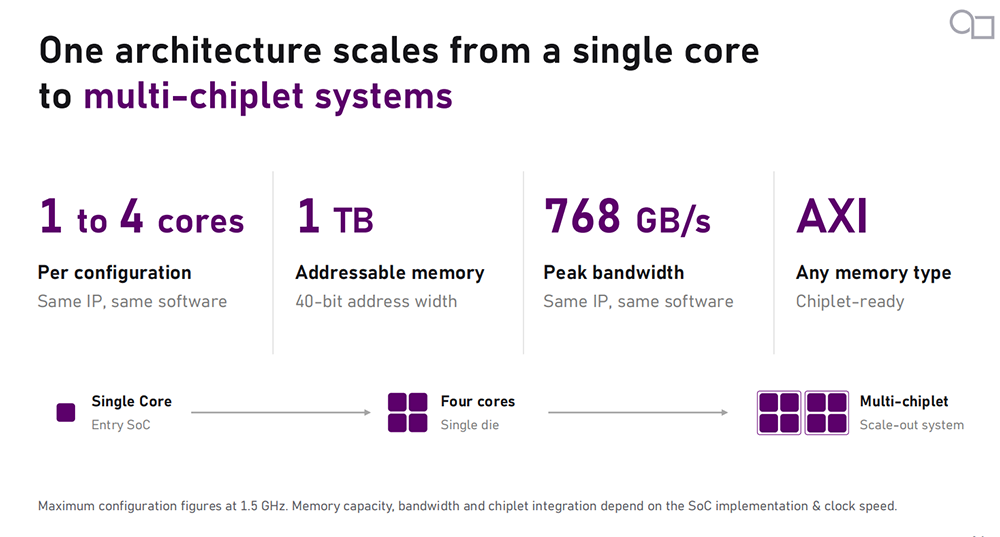
E系列可从单核扩张到四核,支柱40位地址空间,可寻址内存可达1TB,峰值内存带宽为768GB/s,并可通过AXI衔接HBM、LPDDR、GDDR或调理内存。
凭借一颗处理器、一套软件栈,该GPU IP既可孤苦入手,也可与CPU止境他加快器协同,支柱生成式AI、神经渲染与游戏等多种责任负载。
三、支柱多精度AI诡计,跑大模子推理算力飙4倍
AI模子莫得一种数据技艺概况适合通盘应用。据Imagination Technologies首席营收官Jake Kochnowicz分享,E系列初度将BF16、MXFP8、MXFP4等数据技艺引入镶嵌式界限。
在1GHz下,单核可提供约2TFLOPS FP32性能,启用矩阵诡计后可提供16TFLOPS FP16/BF16性能,以及32TOPS INT8/FP8算力和低精度AI算力。
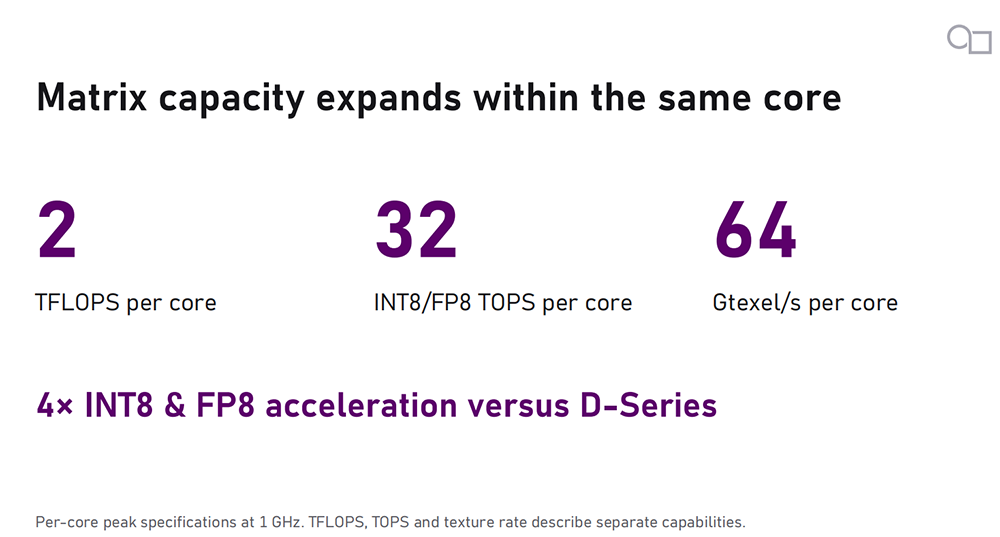
四核高性能成就可提供越过100TFLOPS的FP16/BF16性能,以及越过200TFLOPS的INT8/FP8算力——比上一代D系列逾越4倍以上。
大言语模子推理不错分为Prefill(预填充)和Decode(解码)两个阶段。
Prefill需要一次性处理用户输入和坎坷文,诡计量较大,主要影响Time to First Token,也即是TTFT。E系列的Prefill诡计性能比较上一代最高晋升4.7倍,能让腹地AI应用更快反应。
Decode逐一生成后续Token,其速率不时用每秒生成Token料想,并更易受内存容量和带宽影响。单纯加多TOPS不可处理通盘问题。Imagination正在通过软件用具、低比特量化和模子优化减少权重与数据传输,同期尽量保合手模子精度。
Imagination展示了一些腹地大模子用例:车机旅行缠绵的TTFT约为0.2秒、150tokens/s;视障用户代智能眼镜描述周围环境描述TTFT约为0.25秒、153tokens/s;邮件解读和纲领TTFT约为0.86秒、126tokens/s。
这些收尾评释,在内存受限的系统中,腹地模子有可能已毕不到1秒的首Token反应和越过100token/s的生成速率。
四、神经渲染:特别NSR本事,将AI引入图形处理
E系列GPU IP将可编程AI加快高效集成进GPU渲染管线。
神经超分有几种作念法。常见的一种是图形与AI分开,GPU先以较低辞别率完成渲染,把图像写入DDR,孤苦NPU再从DDR读取图像、实施AI超分并写回收尾。这个经过需要屡次拜访外部内存。
另一类决策把AI加快器放到GPU旁,但还没统共耦合,图形和AI仍使用不同的编程表情,数据照旧要在缓存和片上各处搬。
Imagination的聘请是将矩阵智商径直镶嵌GPU算术单位里面,让数据留在矩阵加快器傍边,使图形与AI诡计分享更多GPU资源。
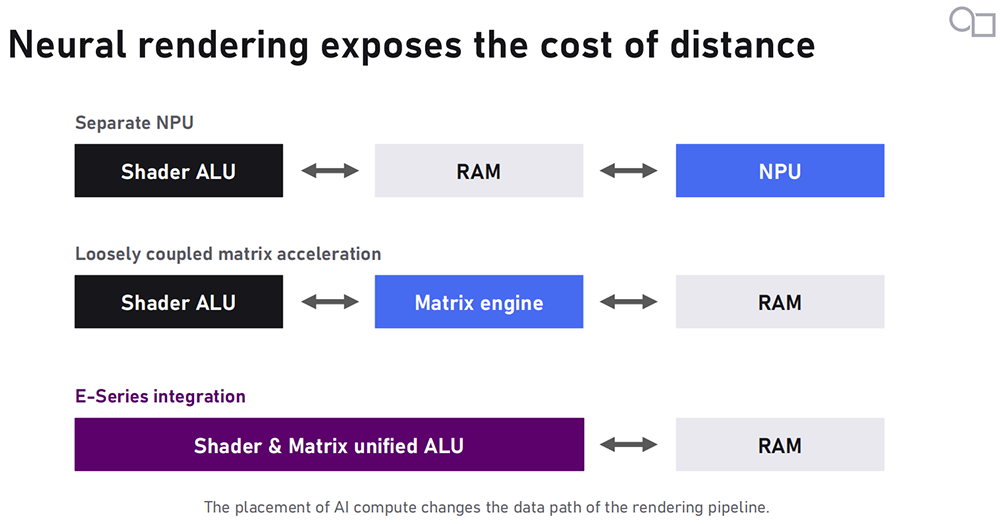
与一些桌面端GPU渲染整帧再超分的作念法不同,Imagination GPU为内存资源有限的端边建立设想,接收分块蔓延渲染(TBDR),把屏幕切成更仆难数个小块,一次处理一个块,在单个tile上同期干完图形和AI,是以效能极高。
这意味着图形蛊惑者惟有写一套shader(Vulkan或OpenCL),在统一套编程范式下就能跑图形渲染和AI,毋庸再把数据引出到DDR。
为此,Imagination蛊惑了特别的神经超辞别率(NSR)本事。
该本事欺诈行业表率扩张,将E系列的矩阵加快本事应用于图形处理管线。
当时序超辞别率决策针对Imagination GPU进行了深度优化,并接收单次处理表情,麇集Imagination特别的收罗自压缩本事,可移除神经收罗中约65%的冗余权重,模子更省电。
与原生渲染比较,NSR不仅将帧率权贵晋升,还将内存带宽破费减半,同期呈现出与真正图像视觉后果极为接近的画质。
在单核E系列上,将540p画面晋升至1080p仅需2.3毫秒;从1080p晋升至4K时,带宽破费最高可裁减54%帧率晋升至2.5倍。
NSR将看成库功能集成于PowerVR SDK中,并通过与Unreal Engine和Godot的集成提供支柱。
Godot引擎公司W4 Games的本事总监Clay John合计,蛊惑者不时需要在视觉质地和性能之间进行衡量,针对硬件优化的超辞别率处理决策则不错改变这种均衡,让路发者在保合手一样致使更高性能水平的同期,有更多空间晋升视觉质地。
五、调理软件栈裁减蛊惑门槛,让GPU IP更易集成与优化
E系列GPU IP接收调理的软件架构和软件栈。客户不错在不同中枢数目和性能成就之间扩张,同期延续已有的软件蛊惑过问。
Imagination GPU支柱行业表率API,并提供诡计库、编译器、性能分析器和蛊惑用具,匡助蛊惑者完成应用蛊惑、优化和部署。
为简化向Imagination GPU的移植,Imagination正在将经过优化的Llama.cpp后端孝敬至上游开源名堂,后续还将提供原生PyTorch和ONNX Runtime支柱。
E系列提供硬件邮箱、低蔓延任务叮属和分享内存机制,用于同SoC中的CPU、NPU止境他处理器协同,以便客户按需聘请E系列图形、AI和其他诡计智商的组合。
客户不错把Imagination的软件栈接入我方的SDK,在合适的时候把任务分拨到合适的处理器。
结语:追求真正场景性能,让客户按需集成GPU更省事
Imagination但愿把GPU从图形处理器升级为边际和端侧SoC中的可编程诡计中心,把蛊惑者需要的算力给足,并将设想功耗、性能、面积和纯真性的采选聘请权交给蛊惑者。
“通过将图形、诡计和AI功能整合到一个可编程架构中,咱们为芯片设想厂商提供了一款值得恒久构建和演进的平台型处理器。”Markus Mosen说。
对中国芯片设想企业而言,E系列的竞争力主要在于负载交融、数据移动、软件复用和往日适合性。
象帝先诡计本事有限公司总司理张珩称,Imagination之是以能成为象帝先多代居品的配结伙伴,收获于其前瞻性的GPU道路图,以及在GPU设想中优先追求真正场景性能、晋升用户体验而非单纯峰值TOPS和FLOPS的求实理念。
看成孤苦GPU IP,E系列可支柱RISC-V、Arm或x86等不同CPU组合,同期图形和诡计分享更多硬件资源,裁减异构数据搬运及多套软件栈的弘扬本钱万博manbext体育官网app娱乐,在算法快速变化时保留更强的可编程性。
下一篇:没有了